Hola a todos. Seguramente te pasó alguna vez: salen las entradas para un recital, empieza el Hot Sale, abre la inscripción a una materia en la facultad o vence un trámite, y la página que siempre anduvo bien de repente tarda una eternidad, tira errores o directamente no carga. La aplicación funcionaba. Lo que no estaba preparado era para tanta gente al mismo tiempo.
Ese es el terreno de las pruebas de performance: verificar no solo que el sistema haga lo que tiene que hacer, sino que lo haga rápido, de forma estable y con la cantidad de usuarios que realmente va a tener. Y dentro de ellas, las pruebas de stress nos permiten ir más allá y descubrir dónde está el límite, qué se rompe primero y cómo se recupera el sistema cuando lo empujamos más allá de lo esperado.
En este artículo te cuento todo lo que necesitás para arrancar: qué son las pruebas de performance, qué tipos existen (carga, stress, picos, resistencia y más), qué métricas mirar y cómo interpretarlas, cómo planificar y ejecutar una prueba paso a paso, cuáles son las herramientas más usadas, con ejemplos de código, cómo encontrar cuellos de botella y cómo integrar todo esto en el pipeline. Al final te dejo un camino para empezar a practicar.
¿Qué son las pruebas de performance?
Las pruebas de performance (o pruebas de rendimiento) son un conjunto de pruebas no funcionales que evalúan cómo se comporta un sistema bajo una determinada carga de trabajo. No se preguntan "¿esto funciona?", sino "¿qué tan bien funciona cuando lo usan muchas personas a la vez, durante mucho tiempo o con volúmenes grandes de datos?".
Concretamente, miden aspectos como:
- Velocidad: cuánto tarda el sistema en responder.
- Capacidad: cuántos usuarios o transacciones puede atender.
- Estabilidad: si mantiene su comportamiento a lo largo del tiempo o se degrada.
- Escalabilidad: si al agregar recursos puede atender más carga de forma proporcional.
- Uso de recursos: cuánta CPU, memoria, disco y red consume para hacer su trabajo.
Un error común es pensar que "performance" es un solo tipo de prueba. En realidad es una familia: la prueba de carga, la de stress, la de picos y la de resistencia son todas pruebas de performance, pero cada una responde una pregunta distinta. Elegir la correcta depende de qué querés averiguar.
En el marco de ISTQB, la eficiencia de desempeño es una de las características de calidad del modelo ISO/IEC 25010, y existe una certificación específica, la Certified Tester Performance Testing (CT-PT). Si te interesa, en QARMY tenemos el material ISTQB en español y un simulador del examen CT-PT para practicar.
Por qué importan las pruebas de performance
Es fácil subestimar la performance mientras todo anda bien en el ambiente de desarrollo, con un solo usuario y una base de datos casi vacía. Pero en producción las condiciones son otras, y los problemas de rendimiento tienen consecuencias muy concretas:
- Usuarios que se van. La paciencia de la gente es corta. Una página que tarda varios segundos en cargar pierde visitas, y un proceso de compra lento pierde ventas. El usuario no distingue entre "lento" y "roto": simplemente se va.
- Caídas en los peores momentos. Los problemas de performance aparecen justo cuando más tráfico hay: un lanzamiento, una campaña, un fin de mes, una fecha de vencimiento. Es decir, cuando más cuesta que el sistema se caiga.
- Costos de infraestructura. Un sistema ineficiente necesita más servidores para atender la misma cantidad de usuarios. En la nube, eso se paga todos los meses.
- Reputación. Una caída durante un evento importante se comenta en redes sociales y puede dañar la imagen de una marca durante mucho tiempo.
- Problemas difíciles de arreglar tarde. Muchos problemas de performance vienen de decisiones de arquitectura. Descubrirlos una semana antes de salir a producción es mucho más caro que detectarlos al principio, algo que se relaciona directamente con el enfoque Shift-Left.
Por eso, como QAs, no alcanza con validar que una funcionalidad "anda". También tenemos que preguntar: ¿cuántos usuarios esperamos? ¿Qué tan rápido tiene que responder? ¿Qué pasa el día de mayor tráfico del año? Esas preguntas son el punto de partida de cualquier estrategia de performance.
Tipos de pruebas de performance
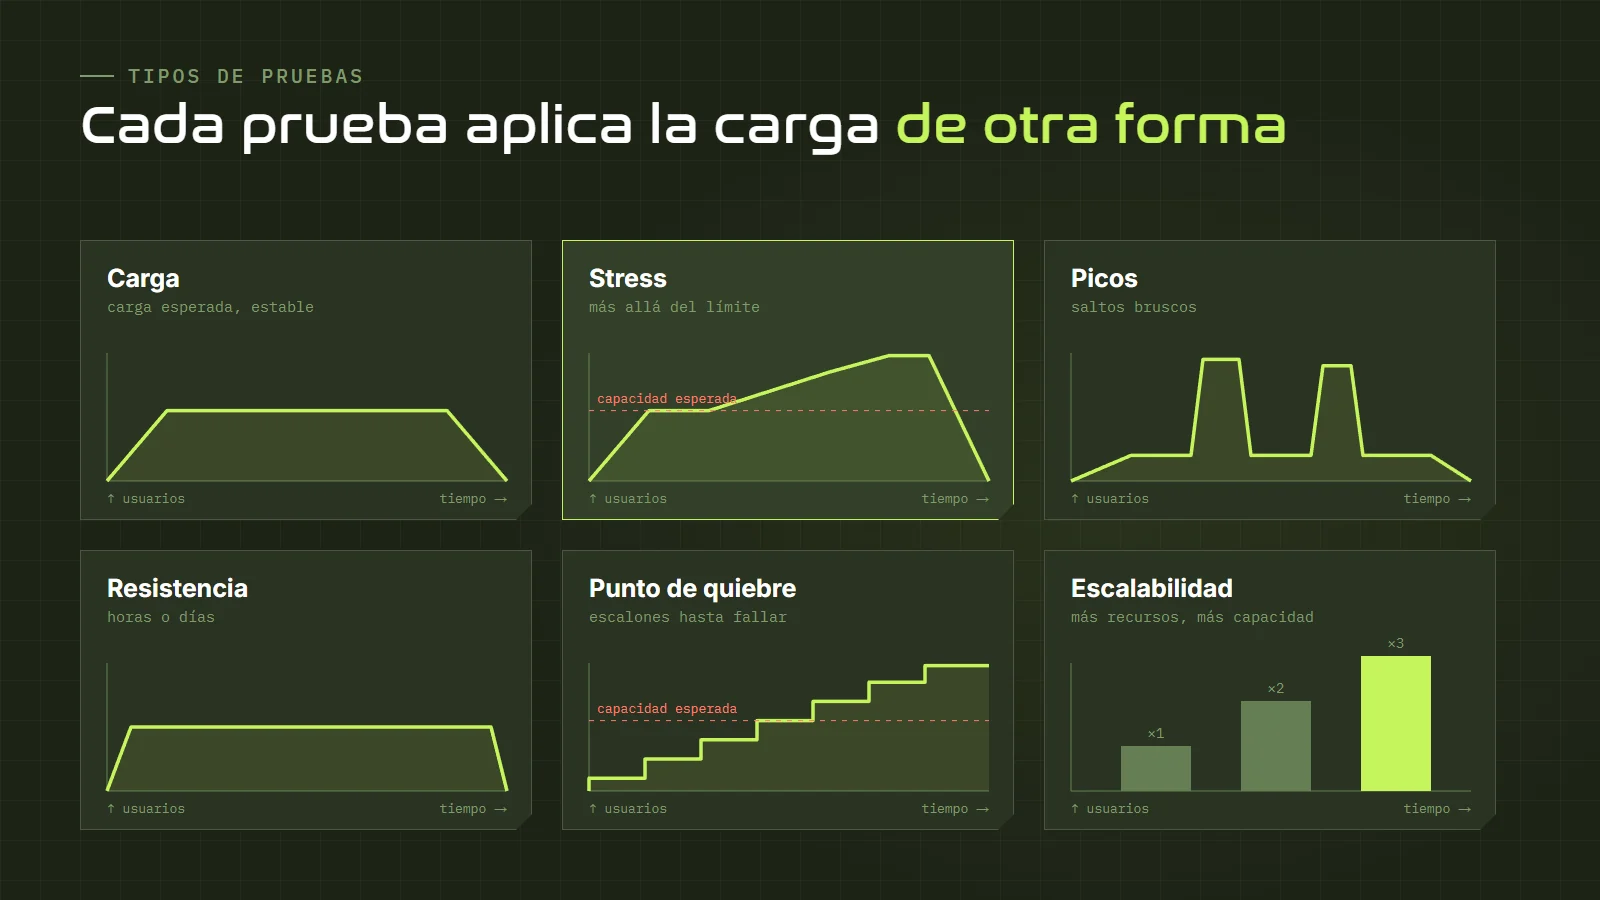
Cada tipo de prueba aplica la carga de una forma distinta para responder una pregunta distinta. La forma más fácil de entenderlos es mirar cómo varía la cantidad de usuarios a lo largo del tiempo:
Prueba de carga (load testing)
Es la más común. Simula la cantidad de usuarios esperada en condiciones normales o de mayor uso habitual, y verifica que el sistema cumpla los objetivos de rendimiento. La carga sube de forma gradual (lo que se llama ramp-up), se mantiene estable durante un tiempo y después baja.
Responde: ¿el sistema soporta la carga que esperamos con tiempos de respuesta aceptables?
Prueba de stress (stress testing)
Lleva al sistema más allá de su capacidad esperada, aumentando la carga hasta que empieza a degradarse o a fallar. El objetivo no es que el sistema "aguante", sino entender cómo falla: qué componente se satura primero, qué errores aparecen, si el sistema falla de forma controlada (por ejemplo, rechazando pedidos con un mensaje claro) o de forma catastrófica, y si se recupera solo cuando la carga baja.
Responde: ¿cuál es el límite, qué se rompe primero y cómo se recupera el sistema?
Prueba de picos (spike testing)
Aplica aumentos repentinos y extremos de carga en muy poco tiempo, y después los baja de golpe. Simula situaciones como la apertura de una venta de entradas, una notificación push enviada a todos los usuarios a la vez o un link que se viraliza.
Responde: ¿el sistema reacciona bien a un salto brusco de tráfico? ¿El autoescalado llega a tiempo?
Prueba de resistencia (soak o endurance testing)
Mantiene una carga normal o moderada durante un período largo: varias horas o incluso días. Muchos problemas no aparecen en una prueba de veinte minutos: fugas de memoria, conexiones que no se liberan, archivos de log que llenan el disco, cachés que crecen sin control o procesos programados que interfieren.
Responde: ¿el sistema se mantiene estable a lo largo del tiempo o se degrada lentamente?
Prueba de punto de quiebre (breakpoint o capacity testing)
Aumenta la carga de forma continua y escalonada hasta que el sistema deja de cumplir los objetivos de rendimiento. Es similar a la de stress, pero el foco está en encontrar el número exacto de usuarios o transacciones por segundo que el sistema soporta. Es muy útil para planificar capacidad.
Responde: ¿cuánta carga máxima soporta el sistema cumpliendo los objetivos?
Prueba de escalabilidad
Evalúa cómo cambia la capacidad del sistema cuando se le agregan recursos: más servidores, más CPU, más memoria. En un sistema bien diseñado, duplicar los servidores debería acercarse a duplicar la capacidad. Si no pasa, hay algo que no escala, por ejemplo una base de datos compartida que se convierte en el cuello de botella.
Responde: ¿agregar recursos aumenta la capacidad de forma proporcional?
Prueba de volumen
En lugar de muchos usuarios, prueba el sistema con grandes volúmenes de datos: una base con millones de registros, un archivo enorme para importar, un reporte que procesa años de información. Una consulta que es instantánea con mil registros puede tardar minutos con diez millones.
Responde: ¿el sistema mantiene su rendimiento cuando crece la cantidad de datos?
¿Cuál conviene hacer?
Si recién empezás, arrancá por una prueba de carga con la carga esperada: es la que más información útil da con menos esfuerzo. Después sumá una de stress para conocer los límites, y una de resistencia antes de salidas importantes. Las de picos son fundamentales si tu negocio tiene eventos con tráfico concentrado.
Métricas que tenés que conocer
Ejecutar una prueba de performance es relativamente fácil. Lo difícil, y lo que más valor aporta, es interpretar los resultados. Para eso hay que entender qué mide cada métrica y cuáles importan de verdad.
Tiempo de respuesta
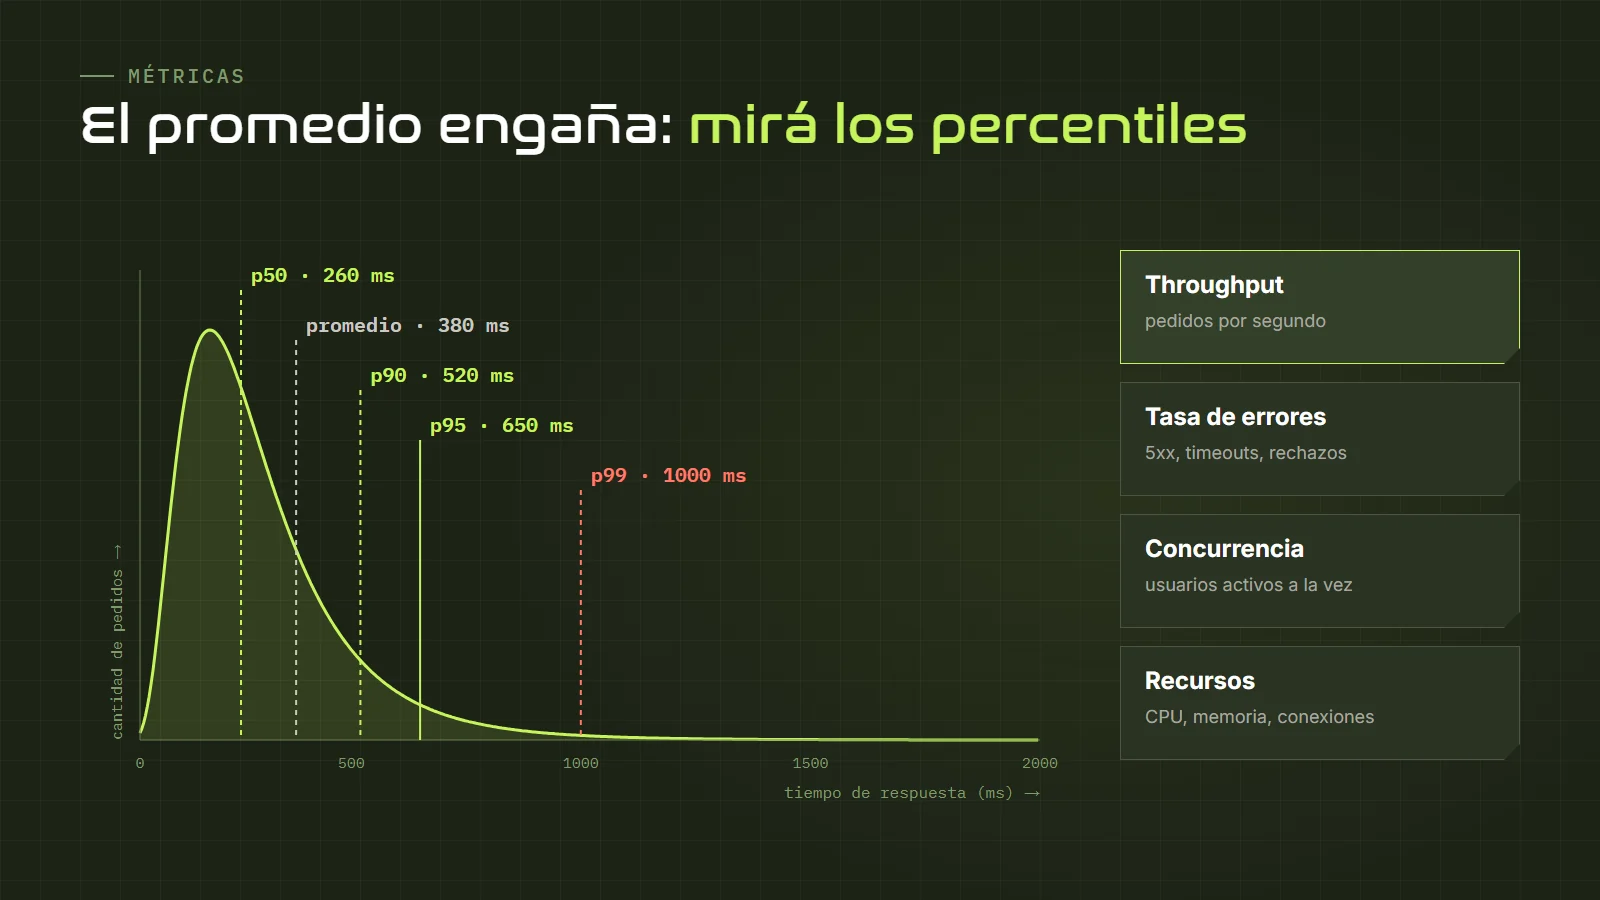
Es el tiempo que pasa desde que se envía un pedido hasta que se recibe la respuesta completa. Es la métrica más visible para el usuario. Pero cuidado con cómo se resume: el promedio engaña. Si nueve pedidos tardan 100 milisegundos y uno tarda diez segundos, el promedio da alrededor de un segundo, un número que no describe a ninguno de los pedidos reales.
Por eso en performance se usan percentiles:
- p50 (mediana): la mitad de los pedidos tardó menos que este valor. Representa la experiencia típica.
- p90 y p95: el 90 % o el 95 % de los pedidos tardó menos que este valor. Son los más usados para definir objetivos.
- p99: el 99 % tardó menos. Muestra la "cola" de la distribución: los usuarios con peor experiencia.
Puede parecer que el p99 afecta a pocos, pero pensá en una página que hace veinte llamadas al servidor: la probabilidad de que al menos una caiga en ese 1 % más lento es alta. Por eso, en sistemas con mucho tráfico, mirar la cola importa mucho.
Throughput
Es la cantidad de trabajo que el sistema procesa por unidad de tiempo: pedidos por segundo, transacciones por minuto, mensajes por segundo. Es la medida de capacidad. Una señal clásica de saturación es que, al aumentar los usuarios, el throughput deja de crecer mientras el tiempo de respuesta se dispara.
Tasa de errores
El porcentaje de pedidos que fallan: errores del servidor (los códigos 5xx), timeouts, conexiones rechazadas, respuestas incorrectas. Un sistema que responde muy rápido pero con un 10 % de errores no está funcionando bien. Si necesitás repasar qué significa cada código, tenés nuestra referencia de códigos HTTP.
Usuarios concurrentes y usuarios virtuales
Los usuarios virtuales son los usuarios simulados por la herramienta de pruebas. Los usuarios concurrentes son los que están activos al mismo tiempo. Ojo: mil usuarios concurrentes no significa mil pedidos por segundo, porque los usuarios reales leen, piensan y completan formularios entre una acción y otra.
Uso de recursos
CPU, memoria, disco, red, conexiones a la base de datos, hilos, tamaño de colas. Estas métricas del lado del servidor no las da la herramienta de carga: hay que obtenerlas del monitoreo. Son las que explican por qué el sistema se comporta como se comporta.
Apdex y otros indicadores
Algunas herramientas usan el índice Apdex, que resume en un número de 0 a 1 la satisfacción de los usuarios según un umbral de tiempo de respuesta. Es útil para reportes ejecutivos, pero para analizar problemas conviene ir a los percentiles.
Conceptos clave antes de empezar
Objetivos de rendimiento (SLA, SLO y SLI)
Una prueba de performance sin objetivos es solo un experimento. Antes de ejecutar, hay que acordar qué es "aceptable". En la industria se usan tres siglas:
- SLI (indicador): la métrica que se mide, por ejemplo el p95 del tiempo de respuesta del login.
- SLO (objetivo): el valor que se quiere alcanzar, por ejemplo "el p95 del login debe ser menor a 800 ms".
- SLA (acuerdo): el compromiso formal con clientes, con consecuencias si no se cumple.
Un buen objetivo de performance es medible y concreto: "con 500 usuarios concurrentes, el p95 de la búsqueda debe ser menor a un segundo y la tasa de errores menor al 1 %". "Que ande rápido" no es un objetivo.
Ramp-up, estado estable y ramp-down
Casi todas las pruebas tienen tres fases: el ramp-up, en el que los usuarios se suman de forma gradual; el estado estable, en el que la carga se mantiene y se toman las mediciones principales; y el ramp-down, en el que la carga baja. Arrancar con todos los usuarios de golpe (salvo en una prueba de picos) distorsiona los resultados.
Think time y pacing
El think time es la pausa que hace un usuario real entre acciones: leer una página, elegir un producto, completar un formulario. Si tu script no incluye estas pausas, cada usuario virtual genera muchísima más carga que uno real, y los resultados no representan la realidad. El pacing controla cada cuánto un usuario virtual repite el escenario completo.
Modelo abierto y modelo cerrado
En un modelo cerrado hay una cantidad fija de usuarios: cada uno espera la respuesta antes de seguir. Si el sistema se pone lento, los usuarios generan menos pedidos y la carga baja sola. En un modelo abierto los pedidos llegan a un ritmo fijo, sin importar si el sistema responde rápido o lento, como pasa con el tráfico real de internet. El modelo abierto es más realista para sitios públicos y es mejor para detectar saturación. Herramientas como k6 y Gatling permiten elegir entre ambos.
Correlación y parametrización
La parametrización consiste en que cada usuario virtual use datos distintos (usuarios, productos, búsquedas), en lugar de repetir siempre los mismos. Si todos buscan lo mismo, la caché responde todo y los resultados son engañosamente buenos. La correlación consiste en capturar valores dinámicos de una respuesta (un token de sesión, un ID de pedido) para usarlos en los pedidos siguientes, como hace el navegador real.
Cómo planificar y ejecutar una prueba
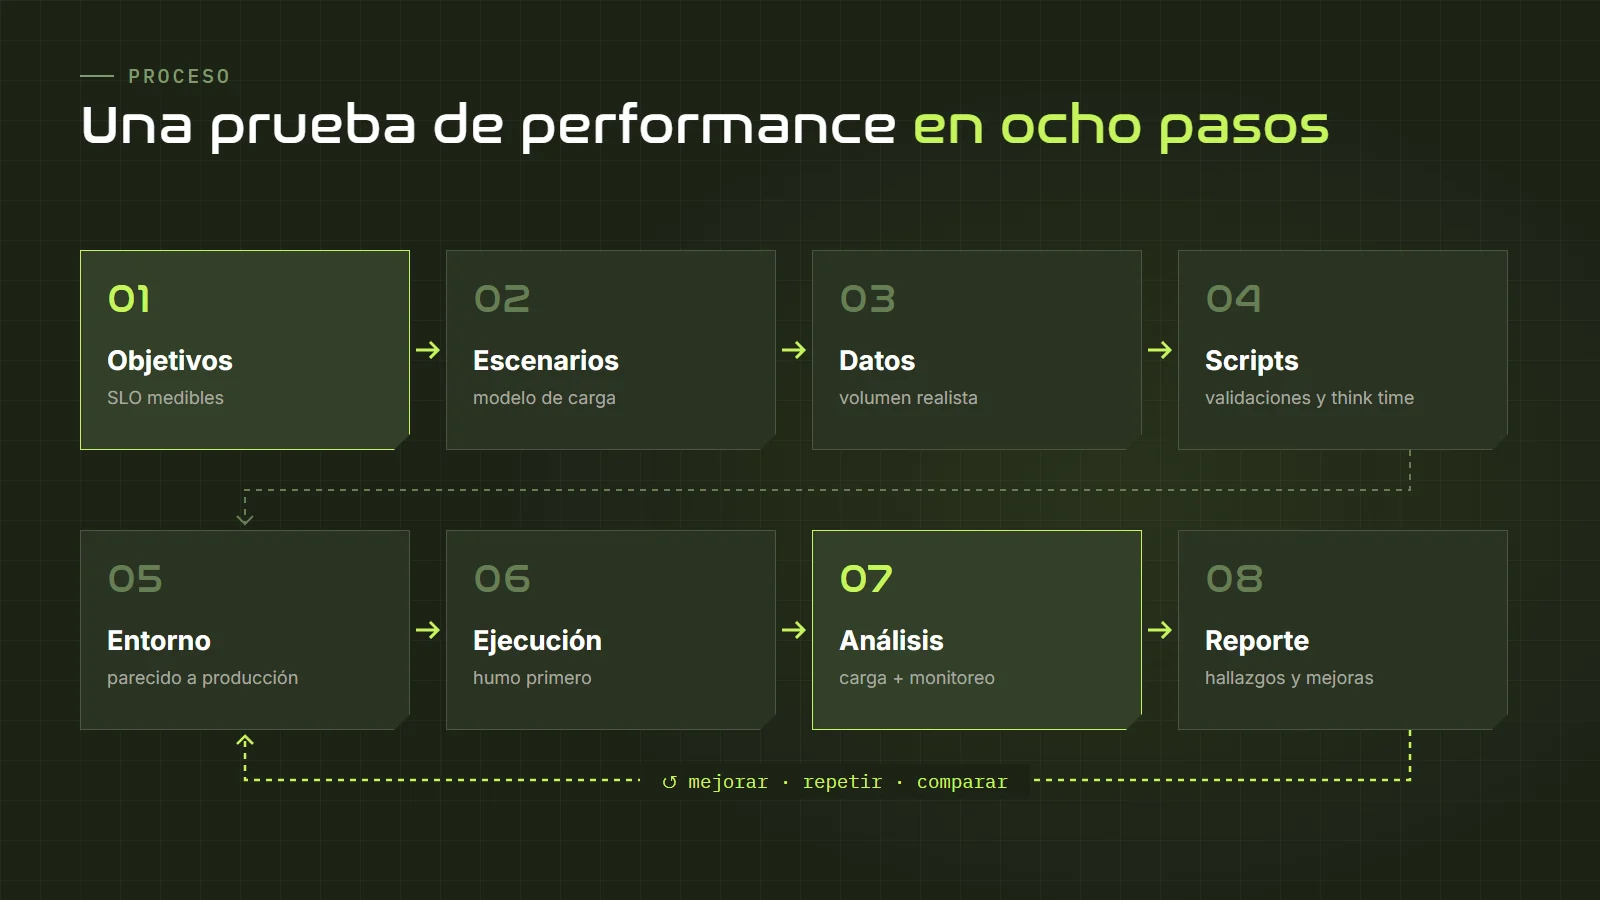
Una prueba de performance bien hecha sigue un proceso que va mucho más allá de "correr la herramienta". Este es el camino que recomiendo:
1. Definir objetivos
Hablá con negocio, producto y desarrollo. ¿Cuántos usuarios se esperan en un día normal y en el pico? ¿Qué transacciones son críticas? ¿Qué tiempos de respuesta son aceptables? ¿Hay eventos especiales en el horizonte? Si el sistema ya está en producción, los datos de analítica y de los logs son la mejor fuente para responder estas preguntas.
2. Diseñar los escenarios
Identificá los flujos que más se usan y los más críticos para el negocio, y armá un modelo de carga: qué porcentaje de usuarios hace cada cosa. Por ejemplo, en una tienda online: 60 % navega el catálogo, 25 % busca productos, 10 % agrega al carrito y 5 % completa la compra. Un escenario donde todos compran al mismo tiempo no representa la realidad.
3. Preparar los datos
Necesitás datos suficientes y realistas: usuarios de prueba, productos, cuentas con saldo. Y la base de datos del ambiente tiene que tener un volumen parecido al de producción. Probar con una base casi vacía es una de las causas más frecuentes de resultados optimistas que después no se cumplen.
4. Escribir los scripts
Traducí los escenarios a scripts en la herramienta elegida, con parametrización, correlación, think time y validaciones: no alcanza con recibir una respuesta, hay que verificar que sea la correcta. Un servidor que responde rápido una página de error no está pasando la prueba.
5. Preparar el entorno
El ambiente de pruebas debería parecerse lo más posible a producción en arquitectura, configuración y recursos. Si es más chico, hay que tenerlo en cuenta al interpretar los resultados. También hay que asegurarse de que los generadores de carga tengan recursos suficientes: si la máquina que genera la carga se queda sin CPU, el cuello de botella es tu herramienta, no el sistema. Y por supuesto, avisá al equipo de infraestructura antes de ejecutar: una prueba de stress sin aviso puede parecer un ataque.
6. Ejecutar
Empezá con una prueba de humo con pocos usuarios para validar que los scripts funcionan. Después ejecutá las pruebas planificadas mientras monitoreás el sistema en tiempo real. Repetí las pruebas más de una vez: un resultado aislado puede estar afectado por factores externos.
7. Analizar
Cruzá los resultados de la herramienta (tiempos, throughput, errores) con el monitoreo del servidor (CPU, memoria, base de datos). Buscá el momento en que el rendimiento empezó a degradarse y qué estaba pasando en ese instante. Ahí suele estar la causa.
8. Reportar y mejorar
Armá un reporte claro: objetivos, escenarios, resultados frente a los objetivos, hallazgos, cuellos de botella identificados y recomendaciones. Después de cada mejora, se vuelve a ejecutar la prueba para comparar. La performance es un ciclo, no un evento. Si querés documentar todo esto dentro de una estrategia más amplia, podés partir de nuestra plantilla de plan de pruebas.
Herramientas para pruebas de performance
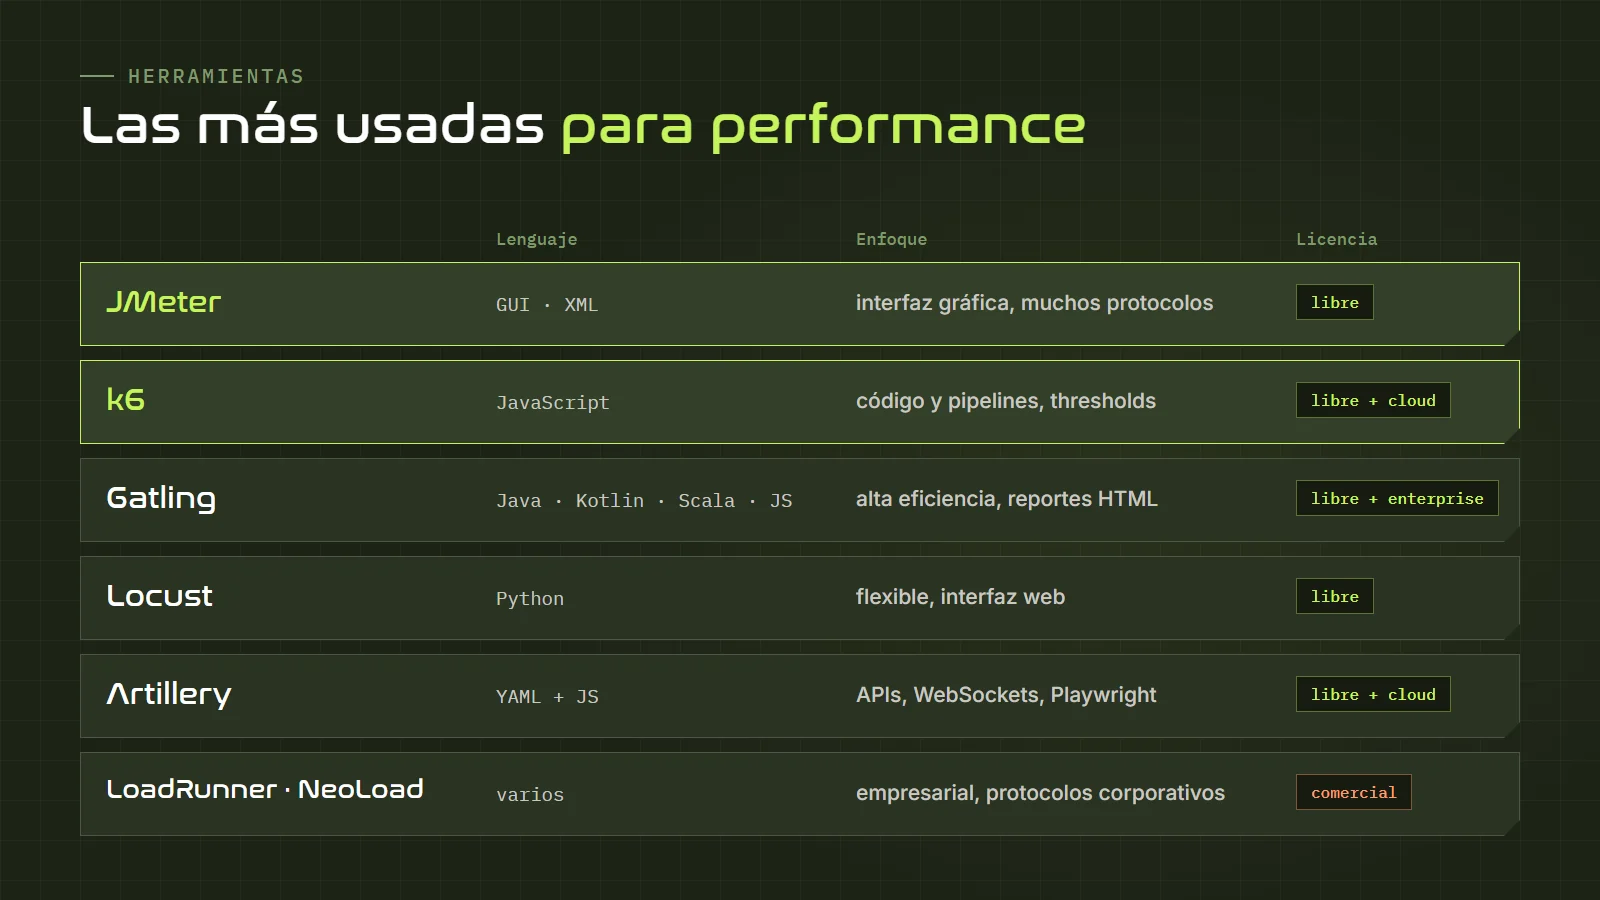
Hay muchas herramientas, gratuitas y comerciales, y cada una tiene su enfoque. Estas son las más usadas en la industria:
Apache JMeter
Es la herramienta de performance más conocida y una de las más antiguas. Es gratuita, de código abierto, está hecha en Java y tiene una interfaz gráfica para armar los planes de prueba sin programar. Soporta muchísimos protocolos (HTTP, bases de datos por JDBC, JMS, FTP, LDAP y más) y tiene un ecosistema enorme de plugins.
A favor: enorme comunidad, mucha documentación, versatilidad y muy pedida en ofertas laborales. En contra: la interfaz se siente antigua, los planes se guardan en XML (difíciles de revisar en un repositorio) y consume bastantes recursos por usuario virtual. Un consejo importante: la interfaz gráfica es para diseñar y depurar; las pruebas reales se ejecutan desde la línea de comandos.
Grafana k6
Herramienta de código abierto, hoy parte de Grafana Labs, en la que los scripts se escriben en JavaScript. Está pensada para equipos que trabajan con código y pipelines: los scripts viven en el repositorio, se revisan como cualquier otro código y se integran fácilmente con CI/CD. Es muy eficiente en el uso de recursos y permite definir thresholds (umbrales) que hacen fallar la prueba si no se cumplen los objetivos.
A favor: moderna, liviana, fácil de aprender si sabés algo de JavaScript, excelente integración con Grafana. En contra: no tiene interfaz gráfica para armar pruebas (aunque tiene un grabador de navegador) y soporta menos protocolos de forma nativa que JMeter, si bien hay extensiones.
Gatling
Herramienta de código abierto con versión comercial, en la que las simulaciones se escriben como código en Java, Kotlin, Scala y también JavaScript. Es muy eficiente, porque usa una arquitectura asíncrona que permite simular muchos usuarios con pocos recursos, y genera reportes HTML muy completos y claros.
A favor: rendimiento, reportes, buen modelo de inyección de carga (abierto y cerrado). En contra: la curva de aprendizaje es mayor si no venís del mundo Java o Scala.
Locust
Herramienta de código abierto en la que los usuarios se definen en Python. Su gran ventaja es la flexibilidad: como el comportamiento es código Python puro, se puede modelar casi cualquier cosa. Tiene una interfaz web para lanzar las pruebas y ver los resultados en tiempo real, y se puede distribuir en varias máquinas.
A favor: ideal para equipos que ya usan Python, muy flexible y fácil de leer. En contra: en una sola máquina genera menos carga que herramientas como k6 o Gatling, aunque se compensa distribuyéndola.
Artillery
Herramienta basada en Node.js en la que las pruebas se definen en YAML, con la posibilidad de agregar lógica en JavaScript. Es muy cómoda para APIs, WebSockets y aplicaciones en tiempo real, y puede integrarse con Playwright para pruebas de carga con navegadores reales.
Herramientas comerciales: LoadRunner y NeoLoad
OpenText LoadRunner (antes de Micro Focus y HP) es una de las herramientas históricas del mercado empresarial, con soporte para una enorme cantidad de protocolos y tecnologías, incluidas aplicaciones corporativas como SAP o Citrix. Tricentis NeoLoad es otra opción empresarial, con un enfoque más moderno y fuerte integración con pipelines. Ambas tienen licencias pagas y se ven sobre todo en grandes organizaciones, bancos y sectores regulados.
Plataformas en la nube
Para generar mucha carga desde distintas regiones sin administrar servidores, existen servicios como Grafana Cloud k6, BlazeMeter (que ejecuta scripts de JMeter, Gatling y otras herramientas), Azure Load Testing o Gatling Enterprise. Son útiles cuando la carga que necesitás supera lo que podés generar con tus propias máquinas.
Herramientas rápidas de línea de comandos
Para una medición rápida de un endpoint, sin escribir un escenario completo, existen herramientas como ApacheBench (ab), wrk, hey u oha. Sirven para una primera idea o para comparar dos configuraciones, pero no reemplazan a una prueba con escenarios realistas.
¿Y Postman?
Postman incorporó una función de pruebas de rendimiento que permite simular varios usuarios virtuales sobre una colección. Es una buena puerta de entrada si ya trabajás con Postman para probar APIs, aunque para pruebas serias de carga o stress conviene una herramienta especializada.
¿Cuál elegir?
| Si tu situación es… | Conviene mirar |
|---|---|
| Recién empezás y no programás | JMeter, por su interfaz gráfica y la cantidad de material disponible. |
| Tu equipo trabaja con JavaScript y pipelines | k6 o Artillery. |
| Tu equipo trabaja con Java, Kotlin o Scala | Gatling. |
| Tu equipo trabaja con Python | Locust. |
| Necesitás protocolos poco comunes o aplicaciones corporativas | JMeter, LoadRunner o NeoLoad. |
| Necesitás carga muy grande desde varias regiones | Una plataforma en la nube. |
Más importante que la herramienta es el criterio: un script mal diseñado da resultados inútiles en cualquier herramienta. Elegí la que mejor se adapte a tu equipo y profundizá en ella.
Ejemplos de scripts
Para que veas cómo se ve una prueba en la práctica, acá van dos ejemplos simples de una prueba de carga sobre una API de productos.
Ejemplo con k6
Este script sube gradualmente a 50 usuarios virtuales, los mantiene durante cinco minutos y baja. Define umbrales: si el p95 supera los 800 ms o los errores superan el 1 %, la prueba falla.
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  stages: [
    { duration: '2m', target: 50 },  // ramp-up
    { duration: '5m', target: 50 },  // estado estable
    { duration: '1m', target: 0 },   // ramp-down
  ],
  thresholds: {
    http_req_duration: ['p(95)<800'], // p95 menor a 800 ms
    http_req_failed: ['rate<0.01'],   // menos de 1 % de errores
  },
};

export default function () {
  const res = http.get('https://api.ejemplo.com/productos?page=1');
  check(res, {
    'status 200': (r) => r.status === 200,
    'trae productos': (r) => r.json('items').length > 0,
  });
  sleep(Math.random() * 3 + 1); // think time de 1 a 4 segundos
}
Se ejecuta con k6 run carga-productos.js, y al terminar muestra un resumen con los percentiles, el throughput, los errores y si se cumplieron los umbrales.
Ejemplo con Locust
El mismo escenario en Locust, con un usuario que navega productos con más frecuencia de la que ve el detalle:
from locust import HttpUser, task, between

class Comprador(HttpUser):
    wait_time = between(1, 4)  # think time

    @task(3)  # tres veces más frecuente
    def listar_productos(self):
        self.client.get("/productos?page=1")

    @task(1)
    def ver_producto(self):
        with self.client.get("/productos/42", catch_response=True) as r:
            if "precio" not in r.text:
                r.failure("respuesta sin precio")
Se ejecuta con locust -f locustfile.py --host https://api.ejemplo.com y se controla desde la interfaz web que levanta en el navegador.
Fijate que en los dos ejemplos hay validaciones de la respuesta y think time. Sin esas dos cosas, la prueba mide algo, pero no lo que te interesa. Y nunca ejecutes pruebas de carga contra sistemas que no son tuyos o sin autorización: además de ser una mala práctica, puede considerarse un ataque.
Monitoreo y observabilidad
La herramienta de carga te dice qué pasó: los tiempos subieron, aparecieron errores. El monitoreo te dice por qué. Una prueba de performance sin monitoreo del lado del servidor es como un análisis médico que solo mide la fiebre.
Estas son las piezas habituales:
- Métricas de infraestructura: CPU, memoria, disco y red de cada servidor o contenedor. Prometheus con Grafana es la combinación de código abierto más popular; en la nube, cada proveedor tiene su propio servicio.
- APM (monitoreo del rendimiento de aplicaciones): herramientas como Datadog, New Relic, Dynatrace, Elastic APM o soluciones basadas en OpenTelemetry muestran cuánto tarda cada parte del código, cada consulta a la base de datos y cada llamada a otro servicio.
- Trazas distribuidas: en arquitecturas de microservicios, permiten seguir un pedido a través de todos los servicios que toca y ver en cuál se pierde el tiempo.
- Métricas de la base de datos: consultas lentas, bloqueos, uso del pool de conexiones, índices que no se usan.
- Logs: errores y excepciones durante la prueba, que muchas veces explican picos de fallas.
Un consejo práctico: armá un tablero que muestre, en la misma línea de tiempo, los resultados de la herramienta de carga y las métricas del servidor. k6, JMeter y Gatling pueden enviar sus resultados a sistemas como InfluxDB o Prometheus para verlos en Grafana junto al resto. Ver en el mismo gráfico que el tiempo de respuesta se disparó justo cuando la CPU de la base de datos llegó al 100 % vale más que cualquier reporte.
Cómo encontrar cuellos de botella
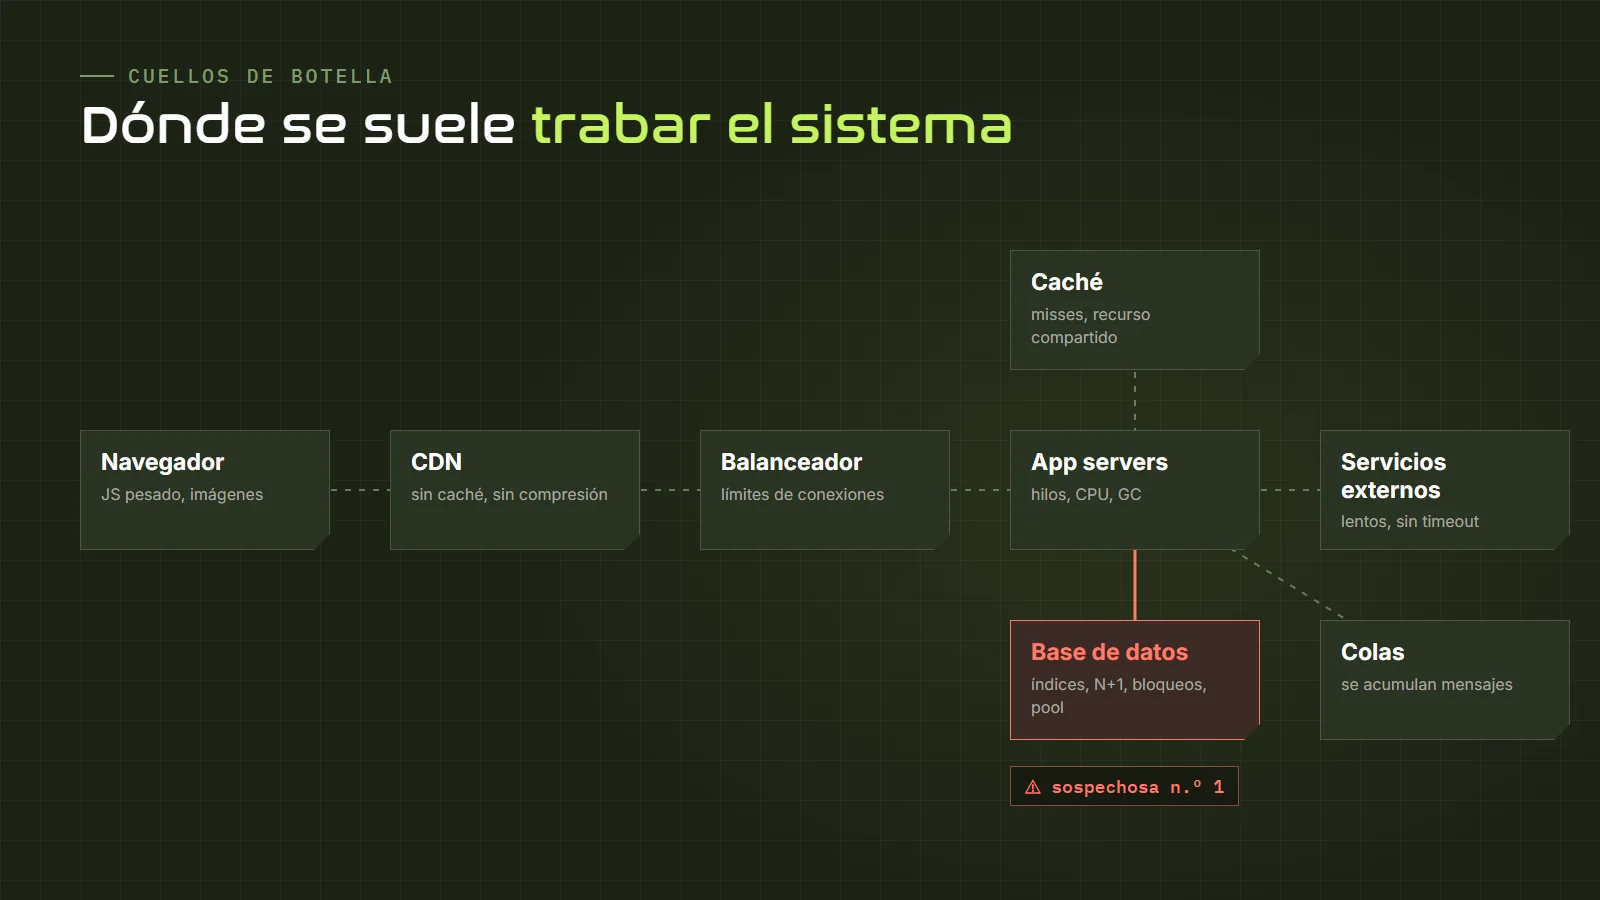
Un cuello de botella es el componente que limita la capacidad de todo el sistema. Siempre hay uno: el trabajo es encontrarlo, decidir si su límite es aceptable y, si no lo es, resolverlo. Y cuando se resuelve uno, aparece el siguiente.
La curva que hay que saber leer
Si graficás el throughput y el tiempo de respuesta a medida que aumentan los usuarios, casi siempre vas a ver el mismo patrón. Al principio, más usuarios significan más throughput y el tiempo de respuesta se mantiene estable. En algún punto el throughput deja de crecer: el sistema llegó a su capacidad. A partir de ahí, agregar usuarios solo hace que los pedidos esperen en cola, y el tiempo de respuesta crece muy rápido. Si se sigue empujando, aparecen errores y el throughput incluso puede caer.
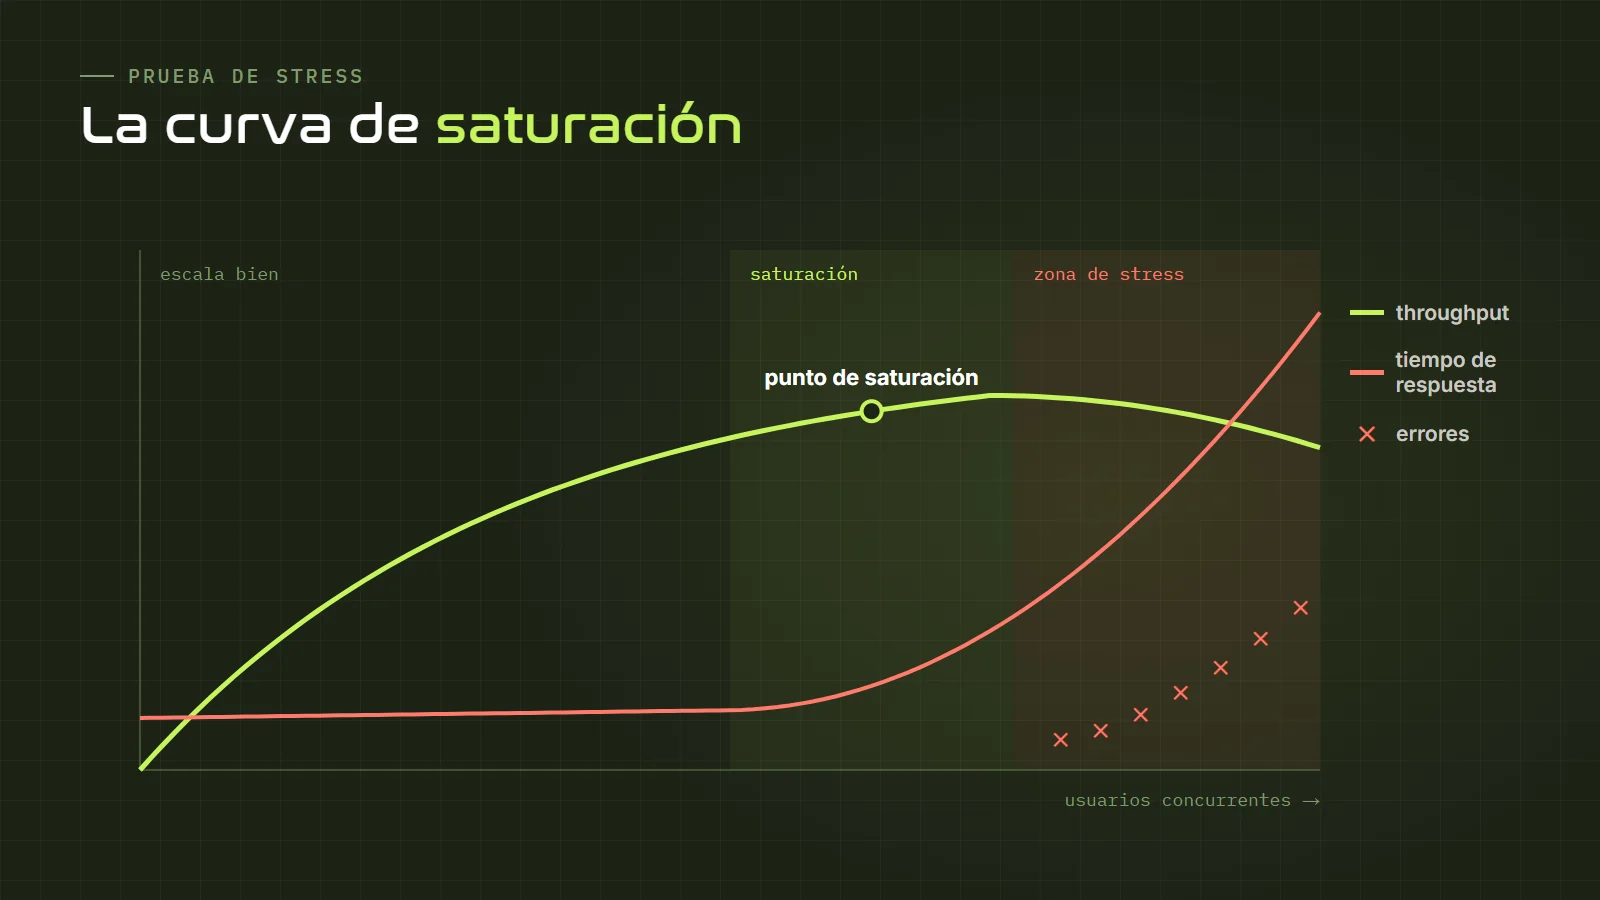
Ese punto donde la curva "se dobla" es el dato más valioso de una prueba de stress: indica la capacidad real del sistema en su configuración actual.
Cuellos de botella frecuentes
- Base de datos: es la sospechosa número uno. Consultas sin índices, consultas que traen muchos más datos de los necesarios, el problema de las "N+1 consultas" (una consulta por cada elemento de una lista), bloqueos entre transacciones y pools de conexiones demasiado chicos.
- Código ineficiente: algoritmos que no escalan, procesamiento innecesario en cada pedido, serialización pesada o falta de caché en datos que cambian poco.
- Servicios externos: una API de pagos o de un proveedor que responde lento arrastra a todo el sistema. Es clave tener timeouts razonables y no esperar indefinidamente.
- Configuración: límites de hilos, de conexiones o de memoria definidos con valores por defecto que no corresponden a la carga real.
- Recolección de basura: en lenguajes como Java o .NET, pausas largas del recolector de basura pueden generar picos de latencia.
- Red y archivos estáticos: imágenes pesadas, archivos sin comprimir y falta de CDN.
- Recursos compartidos: una caché, una cola o un sistema de archivos que todos los servidores usan y no escala con ellos.
Una forma de investigar
Cuando encuentres una degradación, seguí este orden: identificá qué transacción se degrada, buscá en qué momento empezó y con cuánta carga, mirá qué recurso estaba saturado en ese instante y bajá al detalle con el APM o los logs para encontrar la causa concreta. Después, una vez aplicada la mejora, repetí la misma prueba en las mismas condiciones para confirmar el resultado. Sin esa comparación, no sabés si mejoraste algo.
Performance del lado del navegador
Todo lo anterior se enfoca en el servidor, pero el usuario también percibe la velocidad en su navegador o su celular. Una API puede responder en 100 milisegundos y la página igual tardar cinco segundos en ser usable por imágenes pesadas, demasiado JavaScript o recursos que bloquean la carga.
Google definió los Core Web Vitals, métricas que miden la experiencia real de carga:
- LCP (Largest Contentful Paint): cuánto tarda en aparecer el contenido principal de la página.
- INP (Interaction to Next Paint): qué tan rápido responde la página cuando el usuario interactúa.
- CLS (Cumulative Layout Shift): cuánto se "mueve" el contenido mientras carga.
Para medirlas podés usar Lighthouse (integrado en las herramientas de desarrollo de Chrome), PageSpeed Insights y WebPageTest, que además permiten simular dispositivos y redes lentas. Si probás apps mobile, el rendimiento en el dispositivo es todo un tema en sí mismo: lo contamos en nuestra guía de testing en dispositivos móviles.
Una estrategia completa combina las dos miradas: pruebas de carga para saber cuánto soporta el servidor, y pruebas de frontend para saber qué experimenta el usuario.
Performance en el pipeline
Tradicionalmente, las pruebas de performance se hacían una vez, poco antes de salir a producción. El problema es que, si aparece un problema de arquitectura en ese momento, ya es tarde. Hoy la tendencia es incorporar la performance de forma continua:
- Pruebas cortas en cada cambio: una prueba de carga pequeña, de pocos minutos, que corre en el pipeline y falla si se superan los umbrales. No reemplaza a una prueba completa, pero detecta regresiones de rendimiento temprano. k6, Gatling y JMeter se integran fácilmente con GitHub Actions, GitLab CI o Jenkins.
- Comparación contra una línea base: guardar los resultados de cada ejecución y comparar con la anterior. Un aumento del 30 % en el p95 de un endpoint después de un cambio es una señal clara.
- Pruebas completas periódicas: pruebas de carga, stress y resistencia programadas, por ejemplo cada semana o antes de cada versión importante.
- Monitoreo en producción: la performance real se mide con usuarios reales. El monitoreo de producción es la mirada Shift-Right de la performance.
Si ya trabajás con automatización, el framework k0lmena incluye soporte para pruebas de performance junto con las pruebas funcionales y de APIs, para que puedas tener todo en un mismo proyecto.
Errores comunes en las pruebas de performance
- Probar sin objetivos. Sin un criterio de aceptación, no hay forma de saber si el resultado es bueno o malo.
- Mirar solo el promedio. Esconde los problemas. Usá percentiles.
- No usar think time. Genera una carga irreal y conclusiones equivocadas.
- Usar siempre los mismos datos. La caché hace que todo parezca rápido.
- Probar con la base vacía. Los problemas de volumen solo aparecen con volumen.
- No validar las respuestas. Un error que responde rápido no es un éxito.
- Saturar el generador de carga. Si la máquina que genera la carga está al límite, estás midiendo tu herramienta.
- Probar contra servicios de terceros reales. Una pasarela de pagos o un servicio externo no es tuyo para estresar. Usá simuladores (mocks) o ambientes provistos por el proveedor.
- Ejecutar una sola vez. Los resultados varían. Repetí y compará.
- Dejarlo para el final. Los problemas de arquitectura detectados una semana antes del lanzamiento rara vez se resuelven a tiempo.
- No mirar el servidor. Sin monitoreo sabés que algo anda mal, pero no por qué.
Cómo empezar a practicar
Si querés meterte en el mundo de la performance, te propongo este camino:
- Afianzá los fundamentos. Entendé bien cómo funciona HTTP, qué es una API, qué significan los códigos de estado y cómo viaja un pedido desde el navegador hasta la base de datos. Nuestras guías de Swagger y Postman son un buen comienzo, y si estás arrancando de cero, nuestro curso gratuito de QA te da la base.
- Elegí una herramienta y aprendela bien. JMeter si preferís una interfaz gráfica; k6 si te sentís cómodo con un poco de código.
- Armá un laboratorio propio. Levantá una aplicación de ejemplo en tu computadora (hay muchas en Docker) y ejecutá pruebas contra ella. Así podés llevarla al límite sin riesgos. En nuestra lista de webs para practicar testing también vas a encontrar APIs pensadas para practicar, pero recordá respetar sus condiciones de uso: muchas no permiten pruebas de carga.
- Sumá monitoreo. Instalá Grafana y Prometheus o InfluxDB y aprendé a ver los resultados y las métricas del servidor juntos.
- Practicá el análisis. Introducí a propósito un problema en tu aplicación de prueba (una consulta lenta, un pool de conexiones chico) y tratá de encontrarlo solo con las pruebas y el monitoreo.
- Formalizá lo aprendido. La certificación CT-PT de ISTQB ordena todos estos conceptos. Podés practicar con nuestro simulador CT-PT y repasar con el material ISTQB en español.
Preguntas frecuentes
¿Cuál es la diferencia entre una prueba de carga y una de stress?
La prueba de carga verifica que el sistema funcione bien con la carga esperada. La prueba de stress lo lleva más allá de esa carga para encontrar el límite, ver qué se rompe primero y cómo se recupera. La primera responde "¿alcanza?"; la segunda, "¿hasta dónde llega y cómo falla?".
¿Necesito saber programar para hacer pruebas de performance?
Para empezar, no: JMeter permite armar pruebas con su interfaz gráfica. Pero a medida que avances, saber programar te va a ayudar muchísimo, tanto para escribir escenarios complejos como para entender el comportamiento del sistema. Herramientas como k6 o Locust requieren conocimientos básicos de JavaScript o Python.
¿Cuántos usuarios tengo que simular?
Los que correspondan a tus objetivos. Para una prueba de carga, la cantidad esperada en el momento de mayor uso, idealmente basada en datos reales de producción. Para una de stress, bastante más, hasta encontrar el límite. No hay un número universal: depende del negocio.
¿Puedo hacer pruebas de performance en producción?
Es posible, y algunas empresas lo hacen en horarios de bajo tráfico y con mucho cuidado, porque es la única forma de probar la infraestructura real. Pero tiene riesgos evidentes: afectar a usuarios reales, generar datos falsos o disparar costos. Requiere planificación, aprobación y un plan para cortar la prueba de inmediato. Para la mayoría de los casos, lo recomendable es un ambiente lo más parecido posible a producción.
¿JMeter o k6?
Las dos son excelentes. JMeter tiene más trayectoria, interfaz gráfica, soporte para muchos protocolos y es muy pedida en el mercado laboral. k6 es más moderna, liviana y cómoda para equipos que trabajan con código y pipelines. Si tenés tiempo, aprender las dos te abre más puertas.
Conclusión
Las pruebas de performance y stress responden preguntas que ninguna prueba funcional puede responder: cuánto aguanta el sistema, qué tan rápido responde cuando más se lo necesita, dónde está su límite y qué pasa cuando lo supera. Son la diferencia entre un lanzamiento exitoso y una caída en el peor momento.
No se trata solo de la herramienta. Se trata de definir objetivos claros, diseñar escenarios realistas, preparar buenos datos, monitorear el sistema, interpretar los resultados con criterio y repetir el ciclo. La herramienta genera la carga; el análisis lo hacés vos.
Si querés seguir aprendiendo, sumate al canal de WhatsApp de QARMY, donde compartimos novedades, recursos y anunciamos los próximos cursos. Y si ya hiciste pruebas de stress, contanos qué fue lo primero que se rompió: siempre hay una buena historia detrás.